ИИ заполняет параметры модели: классификация и сопоставление
Двенадцать тысяч элементов без кодов классификатора и сопоставление с номенклатурой 1С. Что здесь делает языковая модель, где ошибается и почему её нельзя пускать в модель без правил.
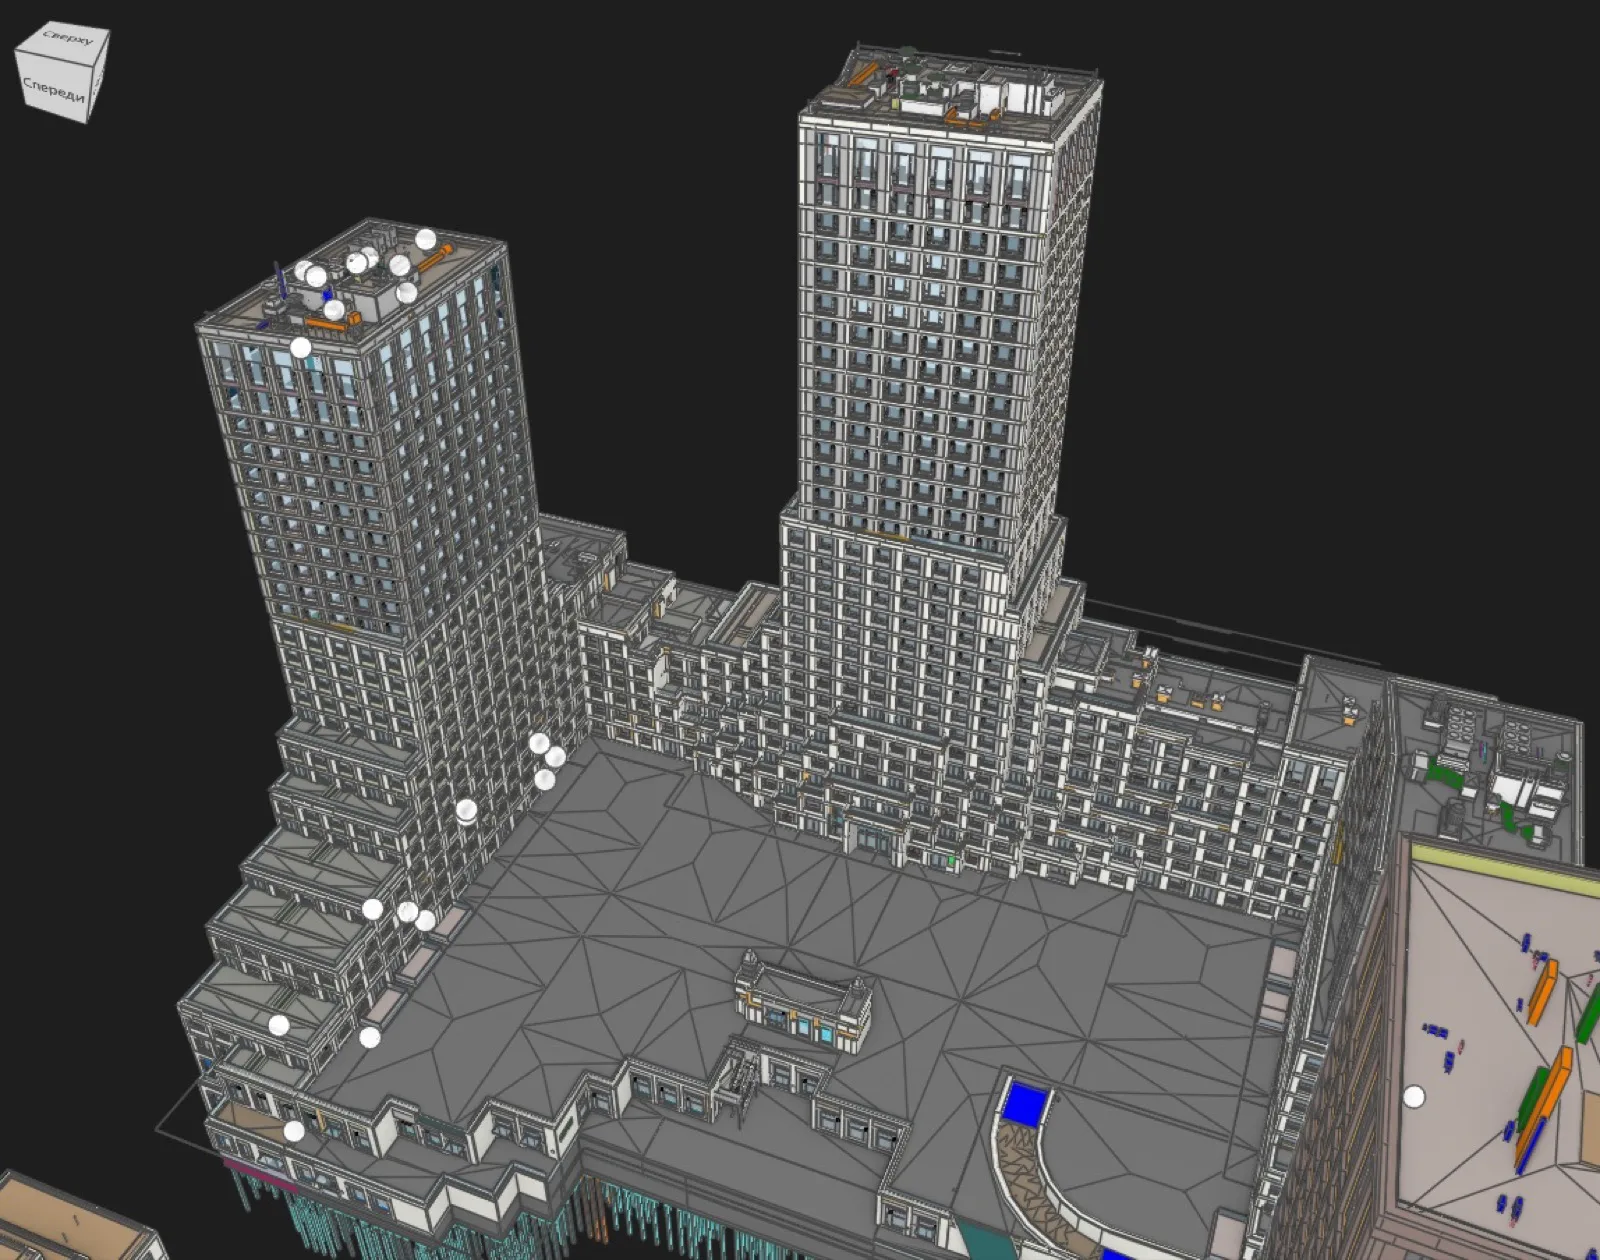
Модель готова, геометрия правильная, а в графе кода классификатора пусто у двенадцати тысяч элементов. Заполнить руками значит потратить две недели работы человека, который будет копировать значения из таблицы и к концу первой тысячи начнёт ошибаться.
Задача выглядит идеальной для языковой модели: есть текстовое описание элемента, есть справочник, надо сопоставить. На практике всё сложнее, но не безнадёжно. Разберём, что здесь получается, а что заканчивается порчей модели.
Три задачи, которые путают
Заполнение по правилу. Всем стенам с типом «Наружная 400 газобетон» проставить материал и код. Тут никакого ИИ не нужно: это фильтр и пакетная правка, десять минут в Dynamo. Если вам предлагают нейросеть для такой задачи, вам продают лишнее.
Классификация. Элементу нужно присвоить код из классификатора: КСР, собственный корпоративный справочник, IFC-класс. Описание элемента текстовое, вариантов в справочнике тысячи, прямого соответствия нет. Вот здесь модель полезна.
Сопоставление с номенклатурой. У элемента есть тип и параметры, а в 1С есть позиция с артикулом. Их нужно связать, чтобы из модели собиралась заявка. Задача похожа на предыдущую, но цена ошибки выше: неправильный артикул означает закупку не того.
Дальше речь про вторую и третью. Первая решается без ИИ, и это стоит помнить.
Почему обычный поиск не справляется
Казалось бы, достаточно поиска по совпадению слов. На практике совпадений нет. В модели написано «Труба стальная ВГП Ду25». В номенклатуре: «Труба стальная водогазопроводная оцинкованная 25х3,2 ГОСТ 3262-75». Общих слов мало, порядок другой, аббревиатура раскрыта. Точный поиск не находит ничего, нечёткий выдаёт десяток похожих позиций разного диаметра.
Добавьте сюда человеческий фактор: сокращения у каждого свои, где-то пробел, где-то дефис, где-то латинская «C» в русском слове «Сгон». Такие подмены букв глаз не различает, а точное сравнение строк различает прекрасно, и позиция просто не находится.
Языковая модель здесь работает лучше поиска, потому что понимает, что «ВГП» и «водогазопроводная» это одно и то же, а «Ду25» относится к диаметру, а не к марке стали.
Как это устроено у нас
Схема, которая выдержала несколько проектов, состоит из пяти шагов, и первые два важнее остальных: они определяют, будет ли человек проверять двести позиций или две тысячи.
Шаг 1. Сначала правила, потом модель. Всё, что сопоставляется однозначно по типу, коду или прямому совпадению, закрывается скриптом. Обычно это 60–70 процентов элементов. К языковой модели уходит только остаток, где правило не сработало.
Шаг 2. Кандидаты, а не свободный ответ. Модель не придумывает код из головы. Мы даём ей список из 10–20 подходящих позиций справочника, найденных нечётким поиском, и просим выбрать одну и объяснить выбор. Разница принципиальная: выбор из списка проверяем, свободную выдумку нет.
Шаг 3. Уверенность обязательна. Ответ должен содержать не только выбранную позицию, но и оценку уверенности с причиной. «Совпал диаметр и материал, но не совпал ГОСТ»: это сигнал человеку посмотреть.
Шаг 4. Порог и очередь на проверку. Высокая уверенность идёт в модель автоматически, средняя попадает в очередь на проверку глазами, низкая возвращается как «не определено». Пустое поле честнее неправильного кода.
Шаг 5. Запись решений. Каждое подтверждённое человеком сопоставление сохраняется в таблицу. На следующем проекте оно закроется правилом на первом шаге, без всякой модели. Через два-три объекта доля ручной работы падает вдвое, и это главный аргумент за такую схему: она дешевеет с каждым проектом, тогда как ручное заполнение стоит одинаково всегда и зависит только от того, сколько людей вы на него посадили.
Цифры, которые получаются
По последнему проекту среднего размера: 11 400 элементов инженерных систем. Правилами закрылось 7 900 позиций, это две трети. Модель обработала оставшиеся 3 500 и предложила варианты: с высокой уверенностью 2 100, со средней 1 000, отказалась от 400.
Человек проверял среднюю группу и отказы, всего 1 400 позиций. Это заняло полтора дня вместо двух недель на всё вручную. Из проверенных высокоуверенных выборочно смотрели 200 штук и нашли 6 ошибок. Все на позициях, где в номенклатуре есть похожие типоразмеры.
Вывод отсюда простой: полностью доверять нельзя даже уверенным ответам, но выборочная проверка ловит систематические промахи быстро.
Где она ошибается предсказуемо
Типоразмеры рядом. 25х3,2 и 25х2,8 для модели почти одинаковы, а для закупки это разные позиции. Лечится просто: числовые характеристики сравниваются отдельно, кодом.
Устаревшие позиции. В справочнике осталась старая номенклатура, помеченная как неактуальная. Модель её выберет, если не сказать, что нельзя. Фильтр по признаку актуальности ставится до передачи кандидатов.
Аналоги и заменители. «Можно взять вот это, оно почти то же самое»: рассуждение полезное для человека и вредное для автоматики. Мы просим модель не предлагать замены, а честно отвечать «не нашёл».
Редкие узлы и нетиповое оборудование. Здесь она угадывает, и точность падает резко. Такие позиции лучше сразу отправлять человеку, определив их по отсутствию близких кандидатов.
Что нужно, чтобы это заработало
Неприятная часть: без порядка в данных ничего не выйдет. Нужен один справочник, а не пять версий в разных отделах. Нужны заполненные типы и параметры в модели: если у элемента написано «Стена 1», сопоставлять нечего ни человеку, ни машине. Нужно решить, кто отвечает за подтверждение спорных позиций, иначе очередь на проверку никто не разберёт.
И нужен обратный ход: когда сопоставление подтверждено, оно должно записаться в модель как параметр, а не жить в отдельной табличке. Иначе следующая выгрузка начнётся с нуля.
Про то, как эти параметры потом доезжают до заявки на закупку, есть разбор про данные модели в PostgreSQL. А про правила, по которым проверяется заполненность, рассказывает страница автоматизации проверки моделей.
Когда не надо
Если элементов меньше тысячи и справочник маленький, возня с настройкой окупится дольше, чем ручное заполнение. Порог начинается примерно с двух-трёх тысяч позиций.
И если в компании ещё не решено, какой классификатор считается основным, начинать надо с этого решения, а не с автоматизации. Автоматизировать спор между отделами не получается.
Нужен похожий BIM/AI процесс?
Напишите в Telegram или на email — разберём задачу и предложим архитектуру решения.
Написать в Telegram Оставить заявку